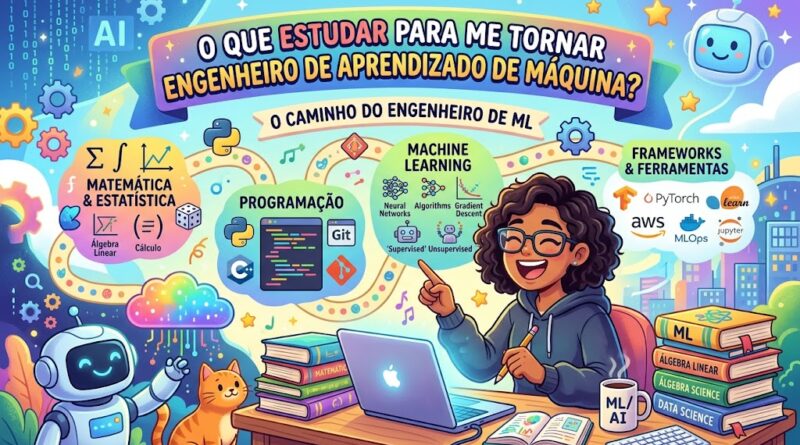
O que estudar para eu me tornar Engenheiro de Aprendizado de Máquina?
Ter um sólido aprendizado em programação, sistemas em produção, APIs, Docker e deploy. Isso é boa parte do que separa um engenheiro de ML de um pesquisador. O que falta é principalmente a base matemática e o ciclo de trabalho com dados e modelos.
1. Python para dados
Você vem de PHP/Java, então a linguagem em si é rápida de aprender. O foco é o ecossistema:
- NumPy, Pandas, Matplotlib/Seaborn
- Jupyter Notebooks
- Ambientes virtuais (venv, uv ou conda)
2. Matemática essencial
Não precisa de nível acadêmico, mas precisa entender o que acontece por baixo:
- Álgebra linear: vetores, matrizes, produto matricial, autovalores
- Cálculo: derivadas, gradientes, regra da cadeia (base do backpropagation)
- Probabilidade e estatística: distribuições, viés/variância, testes de hipótese
- Otimização: gradiente descendente e variantes
Bons recursos: série “Essence of Linear Algebra” e “Neural Networks” do 3Blue1Brown, e Mathematics for Machine Learning (livro gratuito).
3. Machine Learning clássico
Comece por aqui antes de redes neurais:
- Regressão linear e logística
- Árvores de decisão, Random Forest, XGBoost/LightGBM
- Validação cruzada, overfitting, métricas (precisão, recall, F1, AUC)
- Feature engineering e limpeza de dados
- Biblioteca: scikit-learn
Curso clássico: Machine Learning Specialization (Andrew Ng, Coursera).
4. Deep Learning
- Redes neurais densas, CNNs, RNNs e, principalmente, Transformers
- Frameworks: PyTorch (padrão do mercado hoje)
- Curso recomendado: Deep Learning Specialization (Andrew Ng) ou o fast.ai (mais prático, de cima para baixo)
5. IA generativa e LLMs
Hoje é onde há mais demanda, e o seu histórico com chatbots e Anthropic/n8n ajuda muito:
- Como Transformers e LLMs funcionam
- Prompt engineering, RAG, embeddings e bancos vetoriais
- Fine-tuning (LoRA/QLoRA) e avaliação de modelos
- Hugging Face
6. MLOps: onde sua experiência brilha
É o que define o “engenheiro” em ML engineer:
- Servir modelos via API (FastAPI)
- Docker, versionamento de dados e modelos (DVC, MLflow)
- Monitoramento, deploy e pipelines de retreino
- Cloud (AWS SageMaker, GCP Vertex) ou o seu próprio VPS
Ordem sugerida
| Fase | Foco | Tempo aproximado |
|---|---|---|
| 1 | Python para dados + matemática básica | 1-2 meses |
| 2 | ML clássico com scikit-learn | 2-3 meses |
| 3 | Deep learning com PyTorch | 2-3 meses |
| 4 | LLMs, RAG e MLOps | 2-3 meses |
Dica mais importante: aprenda fazendo projetos
Você já tem dados reais e problemas reais. Alguns exemplos que aproveitam o que você já construiu:
- Previsão de vendas ou de inadimplência (fiado) no Salest
- Classificação de intenção de mensagens no chatbot de WhatsApp
- Recomendação de produtos a partir do histórico de vendas
- Kaggle: competições e datasets para montar portfólio
Um portfólio no GitHub com 3 a 4 projetos de ponta a ponta (dados → modelo → API → deploy) pesa mais do que certificados.
Segue uma idéia de plano semanal detalhado com base no tempo que você tem disponível por dia.
Fonte para levantamento de tecnologias: https://epocanegocios.globo.com/inteligencia-artificial/noticia/2026/09/conheca-a-vaga-de-r-25-milhoes-ao-ano-da-openai-que-nao-exige-construir-robos.ghtml
E IA Claude.ia: https://claude.ai/artifact/1tBiADq2UoeUZ4oaEn1B3K e https://claude.ai/share/e5e5b501-704f-475d-aa0a-721b6f747190
Fonte do Mapa Gerado pelo Claude.ia: http://galaxyz.com.br/labs/trilha-engenheiro-llm/Main.dc.html